
Mục Lục Hướng Dẫn
Hầu hết các trợ lý giọng nói AI hiện nay đều gửi giọng nói của bạn lên máy chủ của bên thứ ba để xử lý. Tiện thì có tiện, nhưng nội dung cuộc hội thoại — có thể chứa thông tin nhạy cảm — không còn nằm trong tay bạn. Với các mô hình open-weight hiện nay, bạn có thể dựng một trợ lý thoại chạy hoàn toàn trên máy cá nhân, không cần API key, không tốn phí mỗi lần nói.
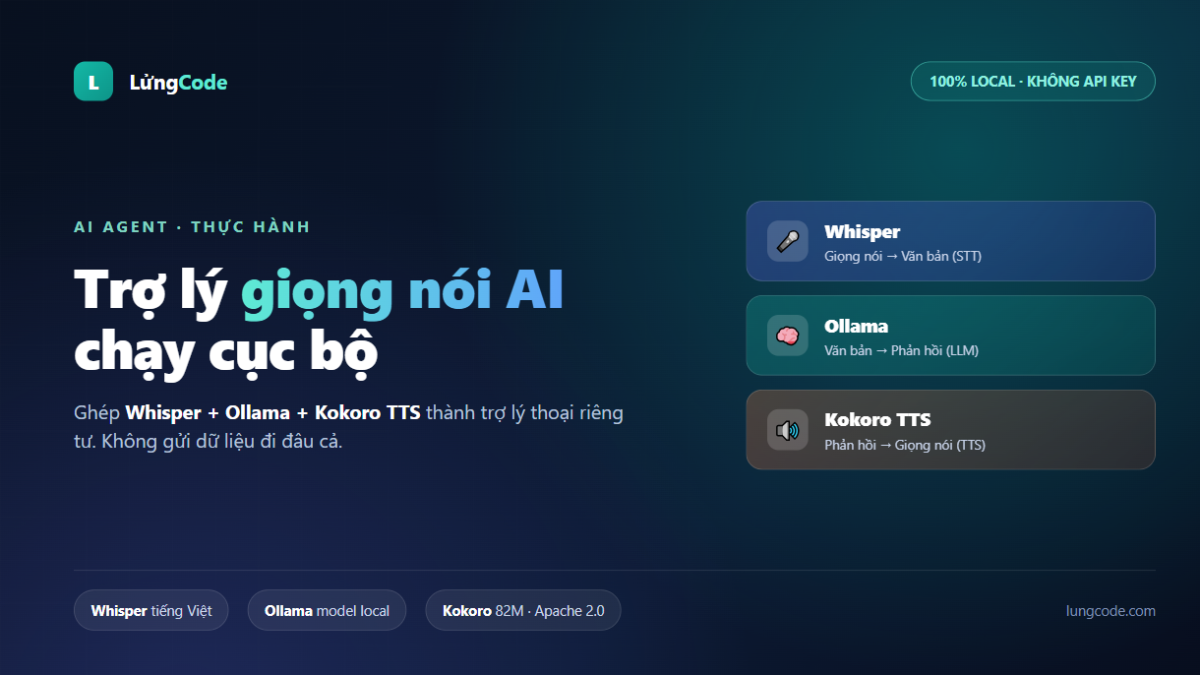
Bài viết này hướng dẫn ghép ba thành phần: Whisper (giọng nói → văn bản), Ollama (văn bản → phản hồi) và Kokoro TTS (văn bản → giọng nói). Đây là kiến trúc 3 tầng kinh điển của một Voice Agent.
1. Kiến trúc 3 tầng của một Voice Agent
Một trợ lý giọng nói hoạt động theo vòng lặp ba bước:
- STT (Speech-to-Text): chuyển giọng nói người dùng thành văn bản → Whisper.
- LLM (Reasoning): hiểu văn bản và tạo phản hồi → Ollama chạy model local như Qwen3.5 9B.
- TTS (Text-to-Speech): chuyển phản hồi thành giọng nói → Kokoro.
Bạn có thể thay từng thành phần bằng solution khác (ví dụ faster-whisper thay Whisper, Piper thay Kokoro), nhưng nguyên tắc ba tầng vẫn giữ nguyên. Điểm mạnh của việc chạy local là toàn bộ dữ liệu ở lại trên máy — phù hợp với xử lý tài liệu nội bộ, y tế, pháp lý hoặc đơn giản là bạn không muốn bị “nghe lén”.
2. Thành phần 1: Whisper — nhận diện giọng nói
Whisper của OpenAI là bộ mô hình STT open-source, hỗ trợ đa ngôn ngữ, chạy được trên CPU lẫn GPU. Với người dùng Việt Nam, điểm đáng chú ý là Whisper nhận diện tiếng Việt khá tốt ở các bản medium trở lên.
Để tăng tốc, hãy dùng faster-whisper — bản tối ưu dùng CTranslate2, chạy nhanh hơn đáng kể so với implementation gốc mà vẫn giữ chất lượng tương đương:
pip install faster-whisperfrom faster_whisper import WhisperModel
model = WhisperModel("small", device="cpu", compute_type="int8")
segments, info = model.transcribe("audio.wav", language="vi", beam_size=5)
text = " ".join(seg.text for seg in segments)
print(text)Mẹo chọn model: tiny/base nhanh nhưng dễ sai; small là điểm cân bằng tốt cho máy 8–16GB RAM; medium chính xác hơn nhưng cần RAM và thời gian lớn hơn. Với máy có GPU, thêm device="cuda".
3. Thành phần 2: Ollama — “bộ não” xử lý ngôn ngữ
Ollama là runtime chạy LLM local dạng dịch vụ nền, có API HTTP rất gọn. Cài đặt và kéo một model về:
ollama pull qwen3.5:9b
ollama run qwen3.5:9b
Để trợ lý phản hồi ngắn gọn (đỡ phải đợi TTS đọc quá dài), hãy đặt system prompt rõ ràng hoặc giới hạn số token. Gọi qua Python:
import requests

def ask_llm(text):
    r = requests.post("http://localhost:11434/api/generate", json={
        "model": "qwen3.5:9b",
        "prompt": f"Trả lời ngắn gọn bằng tiếng Việt: {text}",
        "stream": False,
    })
    return r.json()["response"]
Nếu máy bạn yếu, đổi sang model nhỏ hơn như qwen3:4b hoặc các bản 1–3B — xem bảng chọn model theo RAM.
4. Thành phần 3: Kokoro TTS — tạo giọng nói
Kokoro là mô hình TTS open-weight với 82 triệu tham số, phát hành theo giấy phép Apache 2.0. Dù nhẹ, chất lượng của nó được đánh giá tương đương các mô hình lớn hơn mà chạy nhanh và rẻ hơn đáng kể. Đây là lựa chọn rất hợp cho TTS local.
pip install kokoro soundfilefrom kokoro import KPipeline
import soundfile as sf
pipeline = KPipeline(lang_code='a') # 'a' = tiếng Anh Mỹ
for i, (gs, ps, audio) in enumerate(pipeline("Hello, how are you?", voice='af_heart')):
sf.write(f"out{i}.wav", audio, 24000)⚠️ Lưu ý quan trọng cho người Việt
Kokoro hiện hỗ trợ các mã ngôn ngữ: a (Anh-Mỹ), b (Anh-Anh), e (Tây Ban Nha), f (Pháp), h (Hindi), i (Ý), j (Nhật), p (Bồ Đào Nha-Brazil), z (Trung Quốc). Kokoro chưa có tiếng Việt. Nếu bạn bắt buộc cần TTS tiếng Việt, hãy cân nhắc các mô hình như VieNeu-TTS hoặc Piper với voice tiếng Việt — hoặc dùng Kokoro để đọc các đoạn tiếng Anh trong ứng dụng đa ngôn ngữ.
Trên macOS Apple Silicon, đặt biến PYTORCH_ENABLE_MPS_FALLBACK=1 để bật tăng tốc GPU. Trên Windows, cài thêm espeak-ng (từ trang releases GitHub) để xử lý một số trường hợp fallback.
5. Ghép toàn bộ vòng lặp lại với nhau
Dưới đây là sơ đồ tối giản để bạn thấy luồng dữ liệu. Trong thực tế, bạn sẽ thêm bước thu âm microphone (dùng sounddevice) và phát audio (dùng pygame hoặc sounddevice) thay vì đọc/ghi file cố định:
# 1. STT: audio.wav -> text
segments, _ = model.transcribe("audio.wav", language="vi")
user_text = " ".join(s.text for s in segments)

# 2. LLM: text -> reply
reply = ask_llm(user_text)

# 3. TTS: reply -> giọng nói
pipeline = KPipeline(lang_code='a')
for i, (_, _, audio) in enumerate(pipeline(reply, voice='af_heart')):
    sf.write(f"reply{i}.wav", audio, 24000)
    break
Tối ưu độ trễ
- Dùng
compute_type="int8"cho Whisper trên CPU để tăng tốc. - Giữ model LLM đã tải sẵn trong Ollama — lần gọi đầu tiên chậm, các lần sau nhanh hơn nhiều.
- Giảm
beam_sizexuống 1–3 nếu ưu tiên tốc độ hơn độ chính xác. - Yêu cầu LLM trả lời ngắn (1–3 câu) để TTS không phải đọc quá dài.
6. Ứng dụng thực tế
Một Voice Agent local có thể dùng cho: trợ lý đọc tài liệu nội bộ, hệ thống hỏi đáp không gửi dữ liệu ra ngoài, công cụ hỗ trợ người khiếm thị, hoặc đơn giản là “trợ lý nói chuyện” trên máy bạn. Kết hợp với MCP, trợ lý còn có thể gọi công cụ ngoài — ví dụ đọc lịch, tra cứu file — mà vẫn giữ dữ liệu tại local.
FAQ
Cần cấu hình gì để chạy được?
Tối thiểu 8GB RAM cho Whisper small + model LLM 3–4B. 16GB RAM trở lên cho trải nghiệm mượt với Qwen3.5 9B. GPU rời giúp giảm đáng kể độ trễ.
Có cần API key không?
Không. Cả ba thành phần đều chạy local và miễn phí; bạn chỉ trả chi phí phần cứng.
Tiếng Việt có đọc được không?
Whisper nhận diện tiếng Việt tốt; nhưng Kokoro TTS chưa hỗ trợ tiếng Việt — bạn cần TTS khác nếu bắt buộc đọc tiếng Việt.
Độ trễ khoảng bao nhiêu?
Tùy phần cứng, thường vài giây cho một vòng lặp đầy đủ. Tối ưu bằng cách giữ model sẵn và rút ngắn câu trả lời.
Tài liệu tham khảo: github.com/hexgrad/kokoro, faster-whisper và tài liệu Ollama.